SPORTS
30s
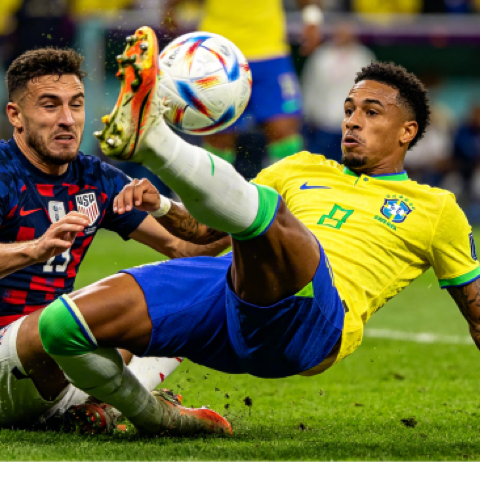
Stadium Goal Commentary
Inside a huge football stadium, tens of thousands of fans roar throughout the background, swelling whenever the action peaks.
输入提示词,创作对白、音乐、环境声和音效。当前在线工作区运行 Seed Audio 1.0。
输入
以提示词为核心,可选更多生成控制。
更多设置
展开后可调整更多输入控制。
历史记录
你最近的 Seed Audio 1.0 生成记录。
登录后可查看生成历史。
Explore tested multi-layer prompt formulas combining character dialogue, environmental beds, foley actions, and musical cues. Click any card to load it into the workspace.
Inside a huge football stadium, tens of thousands of fans roar throughout the background, swelling whenever the action peaks.
A night of pounding rain inside a dim apartment lit by a single lamp; no music, only rain, wind, phone static, footsteps, silence, and the final lock click.
Upbeat podcast intro music fades in clearly, then sits quietly under the voices.
The ad narrator is a young man around thirty years old, with a deep, magnetic, slightly husky voice, speaking Mandarin with clear articulation.
SeedAudio 1.5
SeedAudio 1.5 是字节 Seed 面向完整声音场景的下一代音频模型。seed audio 1.5 用于一次生成对白、音乐、环境声和音效,并支持参考音色、视频感知配音、时间戳和分轨。
相对 Seed Audio 1.0,已公开的 seed-audio-1.5 规格把单次时长从 2 分钟提高到 6 分钟,音频参考从 3 个提高到 6 个。输入模式包括纯文本、文本加音频、文本加视频,以及文本加音频加视频。在线生成器在 SeedAudio 1.5 上线前仍使用 Seed Audio 1.0。
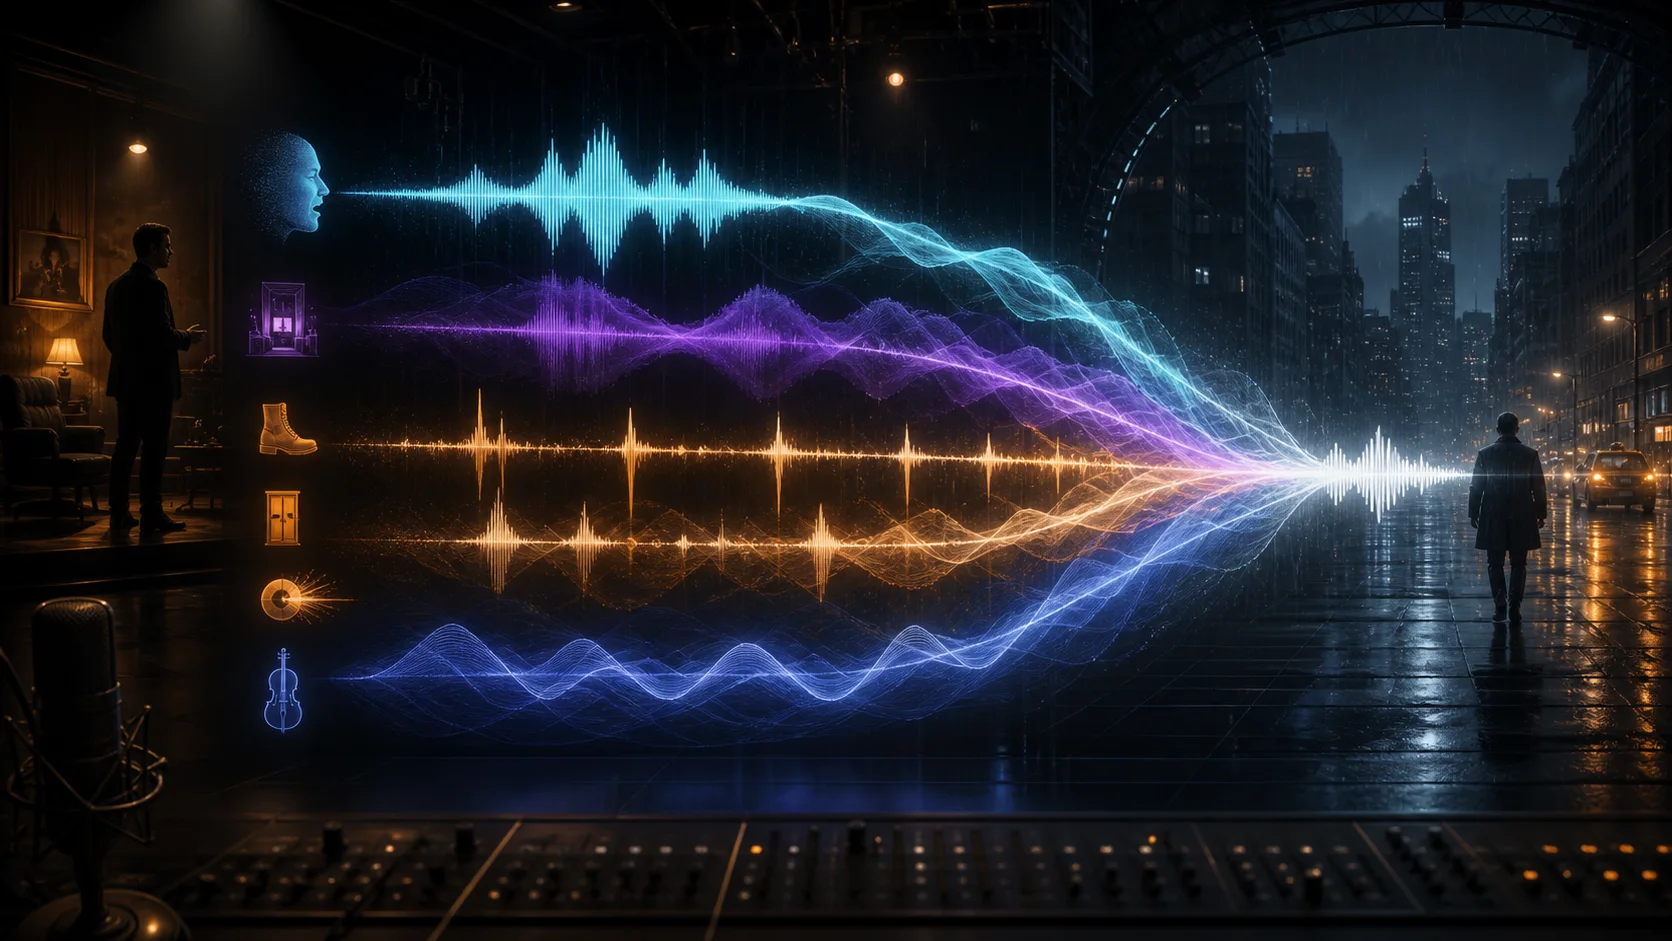
Dialogue
Voices & emotion
Ambience
Room & environment
SFX / Foley
Actions & sync
Music
Score & soundtrack
输入
4 Modes: T2A · TA2A · TV2A · TAV2A文本、音频、视频,共四种已公开输入模式
声音层
Separate Stem Tracks对白、环境声、音效和音乐,并可分轨
输出
Up to 6 Minutes · 6 VoicesSeedAudio 1.5 上线后单次最长六分钟
四份创作说明,四个成品场景
下面每一段音频都始于一份文字说明,把对白、环境声、音效和音乐放在一起描述。它们由本站目前运行的 Seed Audio 1.0 引擎渲染,你可以先听到 1.5 所延续的“先有场景”的思路。
摊主、顾客、滋滋作响的铁板和人群,全部写在一份说明里。适合需要让场景“活起来”的广播剧和短视频。
海边夜市。热情的摊主和年轻顾客在铁板的滋滋声里对话,远处有摩托车声,灯笼轻轻吱呀作响,底下是一段轻柔的尤克里里。
夜市点单
0:15
一位旁白、一间满是细碎声响的厨房,加上轻柔的吉他铺底。展示人声与音乐可以一起设计,而不是事后再混。
一支 15 秒的虚构咖啡烘焙品牌广告。放松的女声旁白、水壶注水声、马克杯落在木桌上,最后一句话下方渐起柔和的原声吉他。
雪松巷的清晨
0:15
角色对白,配上炉火、风声和远处的鲁特琴。适合游戏或互动故事在正式音频制作前先搭出草稿。
暴风雪中的山间酒馆。沙哑的老板告诉紧张的旅人山口已封,背景有噼啪的炉火、拍打窗板的风声和角落里缓慢的鲁特琴。
山口封了
0:18
同一段展厅讲解分别用英文和中文写成,各自带有脚步声和安静的室内底噪。切换标签即可对比。
历史博物馆第三展厅的平静语音导览。沉稳的女性讲解员、石质地面上轻柔的脚步声、远处游客的低语,以及几乎听不见的氛围长音和一个大提琴单音。
第三展厅 · 英文
0:14版本指南
Seed Audio 1.0 已经可以在本站生成混合好的声音场景。SeedAudio 1.5 是即将发布的下一版,把同一思路继续推进:更长的输出、更多参考音频、视频输入,以及可以自己混音的分轨。
| 对比维度 | SeedAudio 1.5(即将上线) | Seed Audio 1.0(现已可用) |
|---|---|---|
| 可用状态 | 即将上线,现在可以下单锁定早鸟价。 | 已上线,登录后即可在上方工作台生成。 |
| 最长时长 | 最长 6 分钟 | 付费计划单次最长 2 分钟;免费预览约 8 秒 |
| 参考音频 | 最多 6 段参考音频 | 最多 3 段音色或参考音频,或 1 张参考图片(二选一) |
| 输入方式 | 文本;文本 + 音频;文本 + 视频;文本 + 音频 + 视频 | 文本提示词,可选参考音频或 1 张参考图片 |
| 语言 | 支持 30 种语言及地区变体 | 多语言对白与口音,通过提示词描述来控制 |
| 视频感知配音 | 视频可作为输入,人声与音效能跟随画面 | 暂不支持,视频不是可用输入 |
| 时间控制 | 可用时间戳指令控制对白、音效和音乐 | 在提示词中描述节奏;时长不是硬性参数 |
| 输出形式 | 对白、环境声、音效、音乐各自独立分轨 | 一个已混合的文件,支持 MP3、WAV、PCM、Ogg Opus |
| 适合场景 | 长篇配音、整集旁白,以及需要分轨做最终混音的项目 | 短场景、广告片段、游戏草稿,以及在大项目前测试提示词 |
| 现在可以做什么 | 下单锁定早鸟价格 | 写提示词、试听、修改,并留下好用的提示词供 1.5 使用 |
SeedAudio 1.5 的数据来自已公开规格,正式上线时可能调整。在此之前,本页生成器运行的是 Seed Audio 1.0。
seed-audio-1.5
已公开的 SeedAudio 1.5 能力覆盖多角色对白、参考音色、30 种语言、视频感知配音、时间戳,以及对白、环境声、音效和音乐分轨。
6 分钟
公开上限,高于 1.0 的 2 分钟
4 种输入
文本、音频和视频的组合
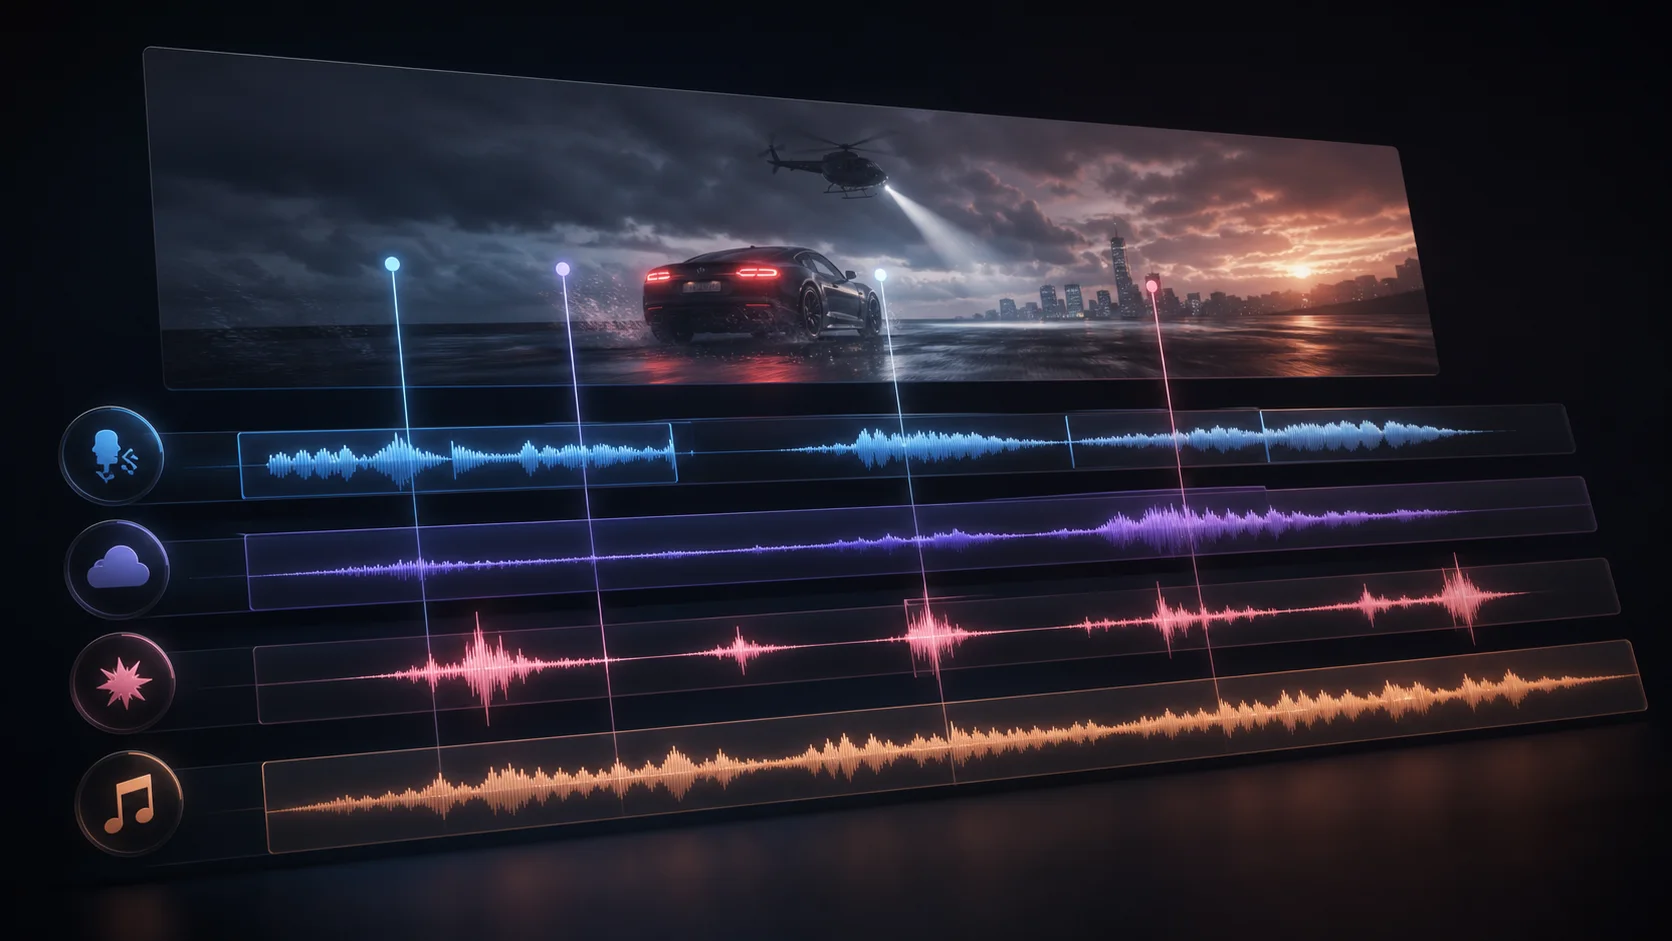
不再把人声、音乐、环境和音效拆到多个工具里拼接,而是在一次生成里编排多层声音。
参考音色可以按情绪、风格、语速和非语言声音来引导。已公开支持最多六个音频参考。
在对白旁同步生成环境底声、背景音乐、房间声、天气、人群或远处城市质感。
SeedAudio 1.5 把已公开的单次时长从两分钟提高到六分钟,更适合较长场景、旁白和配音。
创作可能性
seed audio 1.5 面向视频配音、播客、有声书、游戏场景和需要把对白、环境声、音效、音乐放在一起的广告。
为分镜或预演草拟对白、情绪点、拟音、环境和音乐。
为产品演示、社媒短片和本地化广告快速生成声音方向。
在最终音频制作前,原型化环境循环、角色语音、UI 声和过场声效。
用空间声音线索构建情景课程、角色对话和沉浸式讲解。
带情绪语气的多角色表达
雨声、车流、房间、人群与自然底声
脚步、撞击、开门、质感与时机
使用方法
写下声音场景提示词,按需加入音频或图像参考,设置输出参数,然后生成。现在下单可为 seed-audio-1.5 锁定早鸟价。
描述角色、语言、情绪、地点、对白、环境声、音乐方向,以及你希望出现的声音事件。
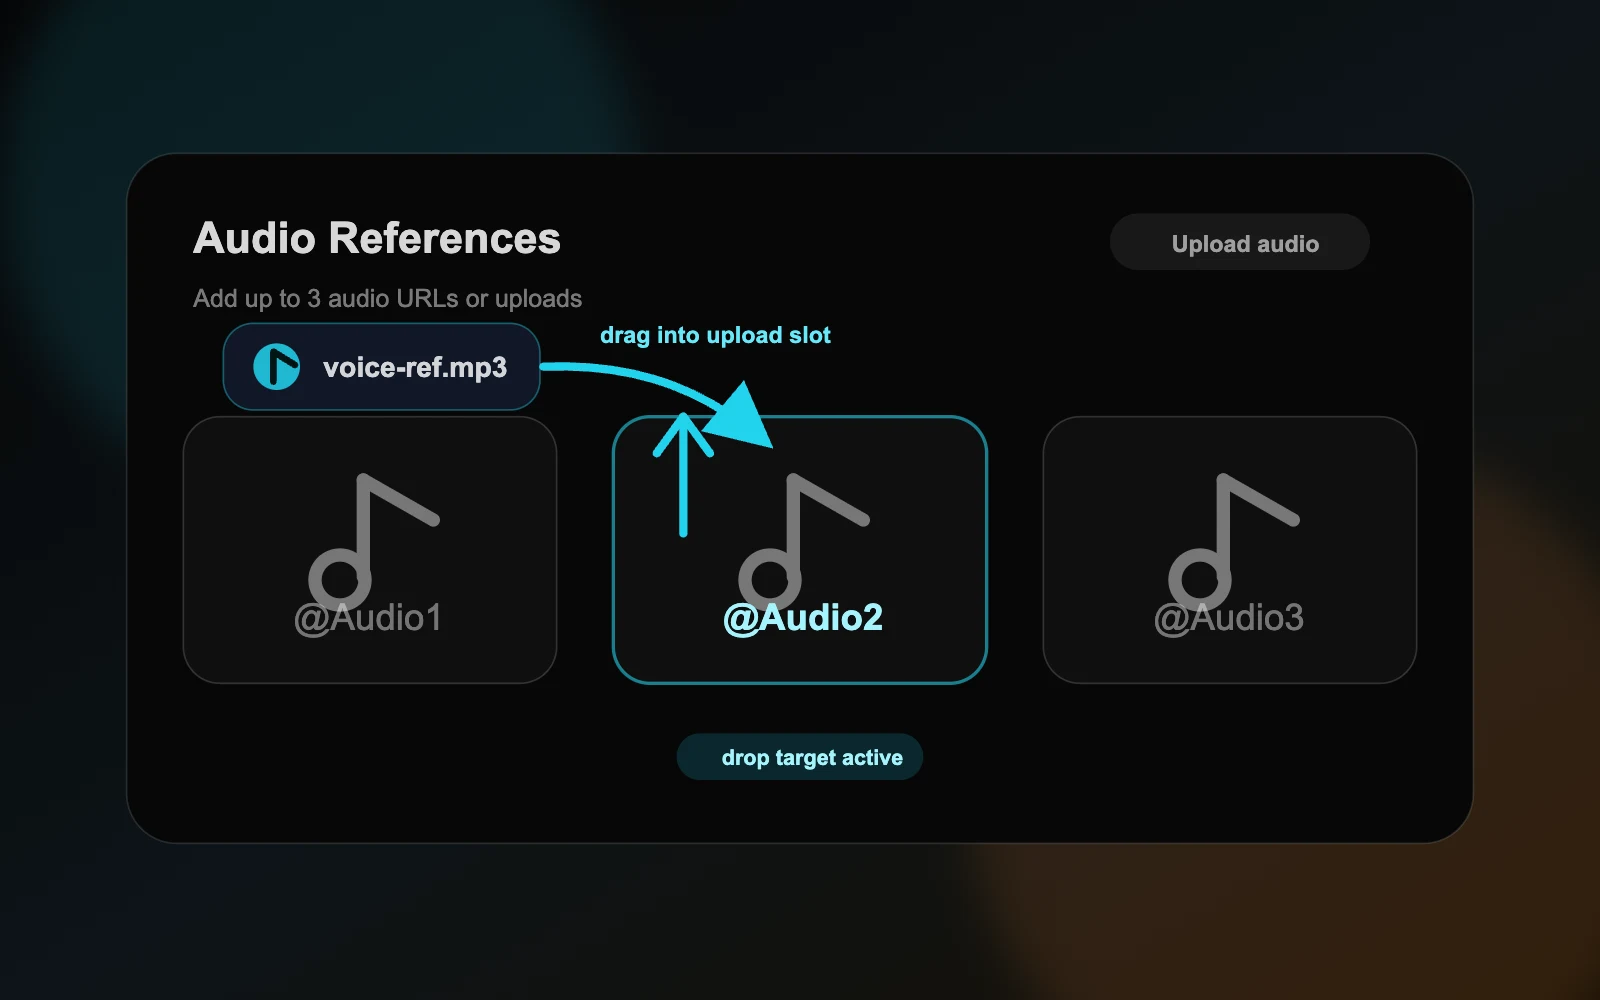
当前 Seed Audio 1.0 生成器最多接受三个音频参考或一张图像。已公开的 SeedAudio 1.5 支持最多六个音频参考,并增加视频感知输入。
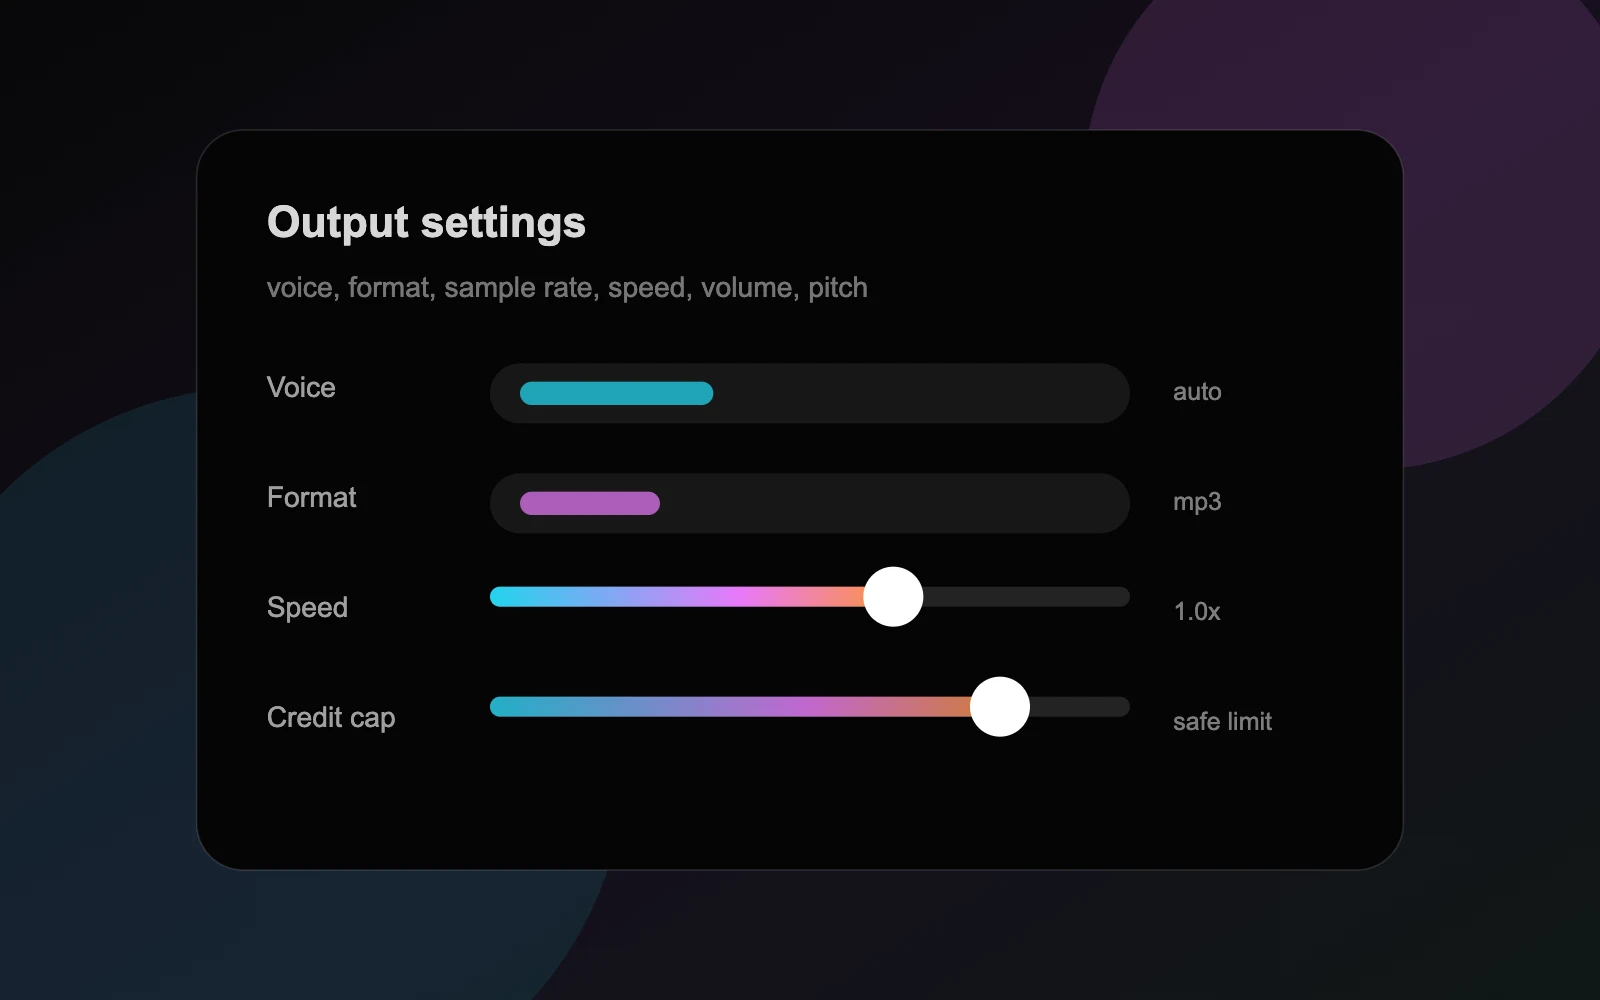
生成前选择声音、输出格式、采样率、速度、音量、音高和最大积分上限。
先生成一段短草稿,检查人声清晰度和各声音层的平衡,再复制、下载或继续修改结果。
提示词公式
场景 + 说话人 + 情绪 + 语言 + 环境声 + BGM + 音效 + 时间节点。
价格
SeedAudio 1.5 即将发布。现在下单即可锁定早鸟价,方案价格保持不变。积分今天就能用于 Seed Audio 1.0 生成器,网页版和 API 共用同一余额。
查看 SeedAudio 1.5 价格无需订阅,小额积分包适合先试用。
适合偶尔做内容项目的灵活积分包。
适合不订阅但需要较高用量的一次性积分包。
常见问题
关于 SeedAudio 1.5、当前 Seed Audio 1.0 生成器和早鸟价的说明。