SeedAudio 1.5 对比 Seed Audio 1.0:完整功能对比
对比 SeedAudio 1.5 与 Seed Audio 1.0 的规格、关键差异和使用场景,帮助你为 AI 音频生成项目选择合适的版本。
SeedAudio 1.5 和 Seed Audio 1.0 都可以在本站使用。这篇对比用来帮你选对模型:要一段可以直接发布的短混音,还是要更长、能吃视频、并且导出分轨的声音场景。
什么是 Seed Audio 1.0?
Seed Audio 1.0 把完整声音场景渲染成一个混音文件:对白、环境声、背景音乐和音效在同一条输出里。登录后写提示词即可生成,也可以加上音色参考,或一张参考图片。
核心规格:
- 时长: 付费计划单次最长 2 分钟(免费预览约 8 秒)
- 参考: 最多 3 段音色或参考音频,或 1 张参考图片(二选一)
- 输入: 文本提示词,可选参考音频或图片
- 语言: 多语言对白与口音,通过提示词描述来控制
- 输出: 一个已混合的文件,支持 MP3、WAV、PCM、Ogg Opus
- 适合场景: 短场景、广告片段、游戏草稿,以及在大项目前测试提示词
把场景类型、地点、角色、情绪、对白、音乐氛围、环境声和音效事件写清楚,Seed Audio 1.0 的效果最好。字节跳动 Seed 在《从“会说”走向“会创作”》里说明了这套场景级做法:人声、音效和环境声放在同一个框架里生成,并写明后续会补上视频输入、更长音频和分轨。
什么是 SeedAudio 1.5?
SeedAudio 1.5(也写作 seed audio 1.5 或 seed-audio-1.5)现已在本站可用。它沿用同一套声音场景流程,并加上更长的输出、更多参考音频、视频输入、时间戳控制,以及可以自己混音的分轨。
规格:
- 时长: 最长 6 分钟
- 参考: 最多 6 段参考音频
- 输入方式: 文本;文本 + 音频;文本 + 视频;文本 + 音频 + 视频
- 语言: 支持 30 种语言及地区变体
- 视频感知配音: 视频可作为输入,人声与音效能跟随画面
- 时间控制: 可用时间戳指令控制对白、音效和音乐
- 输出: 对白、环境声、音效、音乐各自独立分轨
- 适合场景: 长篇配音、整集旁白,以及需要分轨做最终混音的项目
这些是已公开的 SeedAudio 1.5 规格。Dreamina 的模型页列出了四种输入、最长 6 分钟、最多 6 段参考音频、视频感知生成和独立分轨。Pippit 的 SeedAudio 1.5 页面写的是同一组升级:参考音频从 3 段到 6 段,时长从 2 分钟到 6 分钟。登录后即可在工作台生成,使用更长输出、视频输入和分轨导出。
功能对比:SeedAudio 1.5 对比 Seed Audio 1.0
两个版本都已上线。差别在时长、输入,以及你拿到的是一条混音还是独立分轨:
| 对比维度 | SeedAudio 1.5 | Seed Audio 1.0 |
|---|---|---|
| 可用状态 | 现已可用。登录后即可生成,包括视频输入和分轨导出。 | 现已可用。登录后可生成成品混音。 |
| 最长时长 | 最长 6 分钟 | 付费计划单次最长 2 分钟;免费预览约 8 秒 |
| 参考音频 | 最多 6 段参考音频 | 最多 3 段音色或参考音频,或 1 张参考图片(二选一) |
| 输入方式 | 文本;文本 + 音频;文本 + 视频;文本 + 音频 + 视频 | 文本提示词,可选参考音频或 1 张参考图片 |
| 语言 | 支持 30 种语言及地区变体 | 多语言对白与口音,通过提示词描述来控制 |
| 视频感知配音 | 视频可作为输入,人声与音效能跟随画面 | 不支持,视频不是可用输入 |
| 时间控制 | 可用时间戳指令控制对白、音效和音乐 | 在提示词中描述节奏;时长不是硬性参数 |
| 输出 | 对白、环境声、音效、音乐各自独立分轨 | 一个已混合的文件,支持 MP3、WAV、PCM、Ogg Opus |
| 适合场景 | 长篇配音、整集旁白,以及需要分轨做最终混音的项目 | 短场景、广告片段、游戏草稿,以及在大项目前测试提示词 |
关键差异详解
1. 时长:6 分钟 vs 2 分钟
Seed Audio 1.0 在付费计划中把每次生成限制在 2 分钟。免费预览更短,通常在 8 秒左右。SeedAudio 1.5 把上限提升到 6 分钟,完整播客片段、整集旁白或一条广告可以一次生成,不必再拼接多次输出。
2. 参考:6 段 vs 3 段(或 1 张图片)
Seed Audio 1.0 最多接受 3 段音频参考(音色或环境声样本),或一张参考图片,但不能同时使用。SeedAudio 1.5 提高到 6 段音频参考,并增加视频输入,同一次生成可以用多个音色样本、音乐提示或环境音织体来引导。
3. 输入方式:文本、音频和视频
Seed Audio 1.0 接受文本提示词,以及可选的音频或图片参考。SeedAudio 1.5 有四种输入:纯文本、文本 + 音频、文本 + 视频、文本 + 音频 + 视频。可以从脚本和画面剪辑开始,再用参考音乐或音色样本引导配乐,一次完成。
4. 语言:提示词描述 vs 结构化选择
Seed Audio 1.0 靠提示词处理多语言对白:你写出语言或口音,模型据此推断。SeedAudio 1.5 把 30 种语言和地区变体做成明确选项,语言选择不再主要依赖提示词怎么写。
5. 视频感知配音
这是改用 SeedAudio 1.5 最直接的理由。提供视频后,模型可以把对白、音效和音乐对到画面事件上。Seed Audio 1.0 不接受视频,也没有画面时间可跟随。
6. 时间控制:描述式 vs 时间戳
Seed Audio 1.0 的时间写在提示词里,例如「一开始车门猛地关上」或「音乐大约在一半处淡出」。SeedAudio 1.5 增加时间戳指令,对白、音效和音乐进入点可以对准具体的故事节拍。
7. 输出:混音文件 vs 分轨
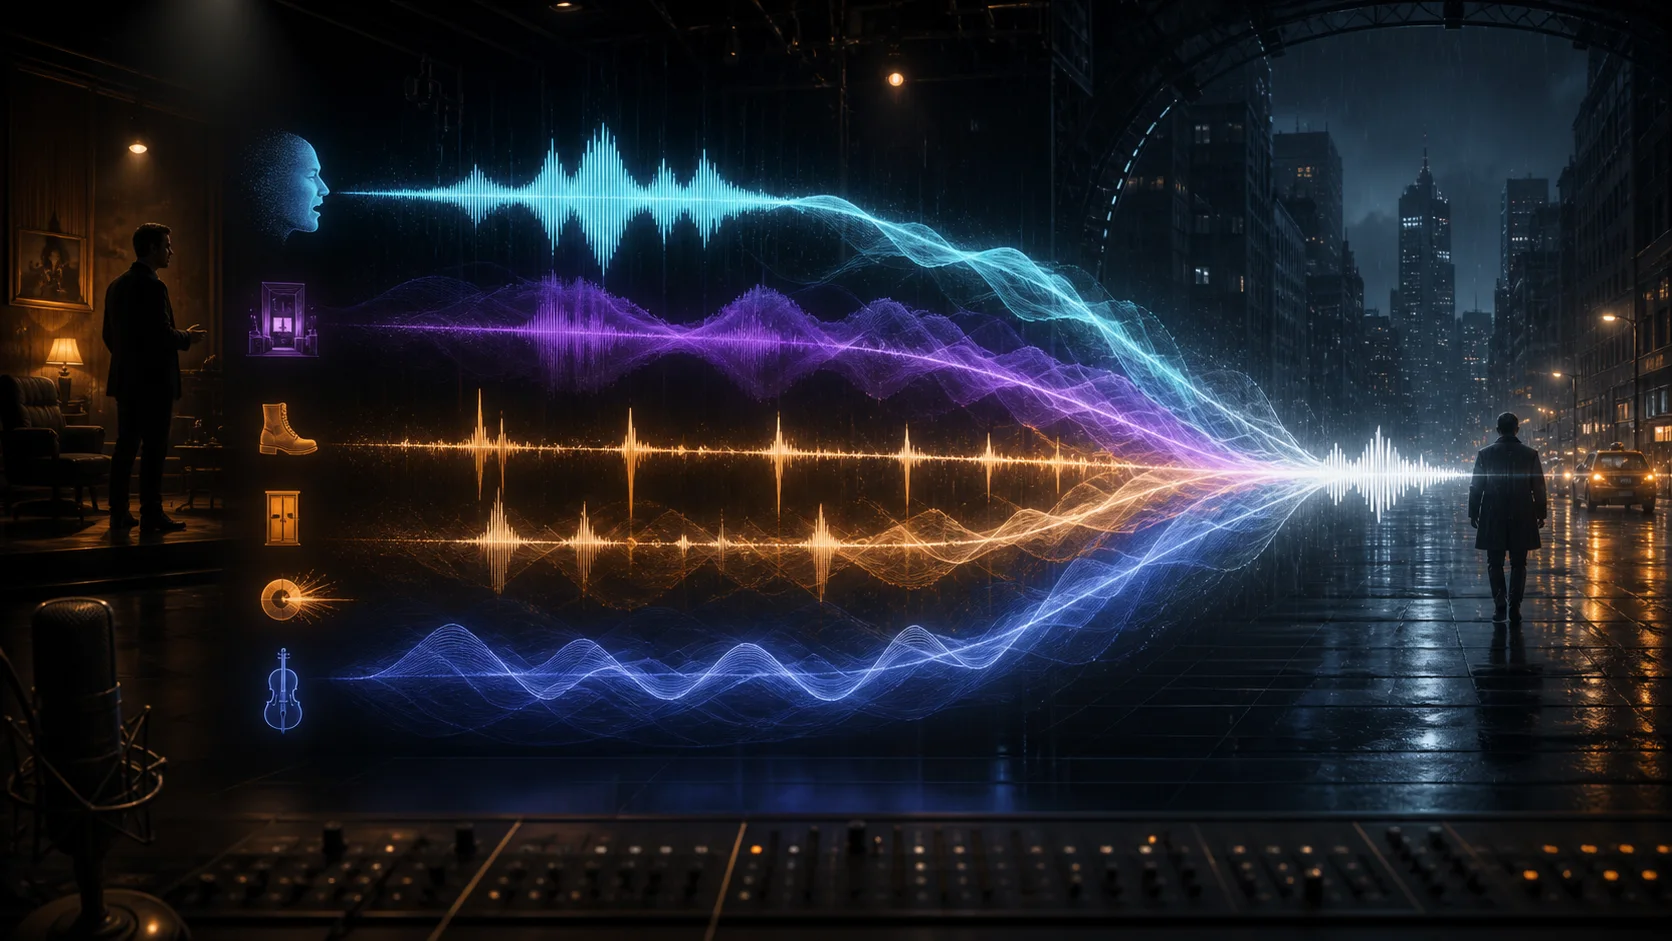
Seed Audio 1.0 交付一条成品混音,生成后不能再调各层电平。SeedAudio 1.5 分别输出对白、环境声、音效和音乐,可以在 DAW 里重新平衡、替换音乐或关掉某一层音效。
使用场景:应该选择哪个版本?
选择 Seed Audio 1.0,如果:
- 内容在 2 分钟以内。 短广告、游戏草稿、播客开场和社交视频都在这个长度里。
- 你要成品混音。 文件已经平衡好,可以直接发布。
- 你在试提示词。 它适合先确认结构、音调和节奏,再做更长的版本。
- 不需要跟画。 文本、音色参考或一张图片就够了。
示例工作流:
- 一段 30 秒的产品演示配音,带欢快背景音乐和轻微的产品交互声。
- 一段 90 秒的游戏过场预览,带角色对白、森林环境声和紧张的管弦乐。
- 一段播客开场,带主持人旁白、音乐床和标志性音效。
选择 SeedAudio 1.5,如果:
- 你需要更长的音频。 2 到 6 分钟,例如完整播客片段或整集旁白。
- 音频必须跟上视频。 叙事成片、广告和教程需要视频感知配音和时间戳。
- 你要重新混音。 独立分轨可以重平衡对白、替换音乐或单独处理音效。
- 项目要做多种语言。 结构化语言支持让本地化更稳定。
示例工作流:
- 一段 5 分钟解说,旁白按脚本走,音效对上画面,音乐在关键台词处让开。
- 一条中英双语广告,音乐和音效分轨分开,方便做地区版本。
- 一集播客按独立音轨交付:主持人旁白、嘉宾对话、咖啡馆环境声和插播音乐。
同一个项目可以两个都用
不必整部片子只选一个模型。
- 短稿先用 Seed Audio 1.0。 场景不长、又想马上听到成品混音时,用它起草。
- 锁定后再用 SeedAudio 1.5。 画面、时长或混音需要视频输入、时间戳或分轨时,换成 1.5。
- 提示词可以留着。 在 1.0 上写清楚的场景描述,到 1.5 仍然描述同一组声音层;只有需要时再补视频、时间戳或额外参考。
常见问题
SeedAudio 1.5 相比 1.0 有哪些新功能?
SeedAudio 1.5 将最大输出时长从 2 分钟延长到 6 分钟,将参考音频上限从 3 段提高到 6 段,增加了用于配音和同步的视频输入,提供独立分轨(对白、环境声、音效、音乐)而非固定混音,支持 30 种带地区变体的语言,并引入时间戳控制以实现精确计时。
SeedAudio 1.5 现在可以使用吗?
可以。SeedAudio 1.5 已在本站上线。登录后即可从工作台生成,使用包括更长输出、视频输入和分轨导出在内的高级功能。
SeedAudio 1.5 最长可以生成多长的音频?
SeedAudio 1.5 每次生成最长支持 6 分钟。Seed Audio 1.0 在付费计划中限制为 2 分钟。
SeedAudio 1.5 能同时生成对白、环境声、音效和音乐吗?
可以。两个版本都能在一个工作流程中生成包含对白、环境声、音效和背景音乐的完整声音场景。区别在于 SeedAudio 1.5 将它们作为可重新混音的独立分轨交付,而 Seed Audio 1.0 交付成品混音。
我可以从 SeedAudio 1.5 导出独立分轨吗?
可以。SeedAudio 1.5 输出对白、环境声、音效和音乐的独立音轨。你可以将这些分轨导入任何 DAW 中重新平衡电平、替换音乐或隔离音效进行最终混音。Seed Audio 1.0 仅提供一个混合文件。
SeedAudio 1.5 接受视频输入吗?
可以。SeedAudio 1.5 支持视频输入,用于视频感知配音和声音设计。模型可以将对白、音效和音乐同步到视觉事件。你可以将视频与参考音频和文本提示词结合使用。Seed Audio 1.0 不接受视频。
我可以向 SeedAudio 1.5 上传多少段参考音频?
SeedAudio 1.5 每次生成最多接受 6 段参考音频,而 Seed Audio 1.0 为 3 段。你可以使用这些参考来引导音色、音乐风格或环境质感。
SeedAudio 1.5 支持哪些语言?
SeedAudio 1.5 支持 30 种带地区变体的语言,包括英语、中文、西班牙语、法语、德语、日语、韩语等。语言选择是结构化的而非仅依赖提示词,使多语言项目更可预测。
我应该从 Seed Audio 1.0 升级到 SeedAudio 1.5 吗?
如果你需要更长的音频(超过 2 分钟)、视频感知配音、时间戳控制或用于最终混音的独立分轨,请使用 SeedAudio 1.5。如果成品混音已足够且场景较短,可以继续使用 Seed Audio 1.0 进行快速测试。
我可以商业使用 SeedAudio 生成的音频吗?
商业使用取决于服务条款。在发布生成的音频之前,请查看服务条款了解许可详情、输出权利和署名要求。
最终建议
用 Seed Audio 1.0 做短场景、提示词测试和 2 分钟以内的成品混音。广告、游戏草稿和社交内容,一条文件就能发的,用它。
用 SeedAudio 1.5 做最长 6 分钟的音频、视频感知配音、时间戳控制或分轨。登录后即可在工作台使用这些能力。
两个版本生成的都是完整声音场景,包括对白、环境声、音乐和音效,而不是孤立旁白。差别在时长、输入方式、时间精度,以及你拿到的是成品混音还是可编辑分轨。
要跟上画面并留下分轨,就用 SeedAudio 1.5 生成。
参考来源
- 字节跳动 Seed:《从“会说”走向“会创作”》 — Seed 团队对场景级音频、时间控制和后续视频输入、长音频、分轨方向的说明。
- Dreamina SeedAudio 1.5 — 已公开的四种输入、6 分钟输出、6 段参考、30 种语言、视频感知生成、时间戳和独立分轨。
- Pippit SeedAudio 1.5 — CapCut 生态里对参考音频 3 到 6、时长 2 到 6 分钟,以及视频感知配音的说明。